Vector Database (向量数据库)
**来源:**Notion **原发布时间:**发布日期: 2025-10-28; 创建时间: 2025-10-28 07:26:39.504Z; 最后编辑时间: 2025-10-28 07:30:12.582Z **标签:**AI、搬运总结
原文:https://almond-oxygen-ceb.notion.site/Vector-Database-29a8b1cc19aa807a9813e67a2c35d5e9?pvs=25
What is aVector Database & How Does it Work? Use Cases + Examples
(翻译和节选自此篇文章)
导览:
- 什么是向量数据库?(略去了和向量索引的对比)
- Serverless 向量数据库
什么是向量数据库?(Whatis a Vector Database?)
向量数据库 (Vector Database)是一种用于索引和存储向量嵌入 (vector embeddings)的数据库,专为实现快速检索和相似性搜索而设计,并具备CRUD 操作、元数据过滤、水平扩展和 Serverless等能力。
我们正处在 AI革命的浪潮中。它正在颠覆所触及的任何行业,许诺带来巨大的创新——但它也引入了新的挑战。对于涉及大型语言模型、生成式AI和语义搜索的应用来说,高效的数据处理变得比以往任何时候都更加重要。
所有这些新应用都依赖于向量嵌入——这是一种向量数据表示形式,它携带的语义信息对于AI 获得理解和维持长期记忆至关重要,AI在执行复杂任务时可以调用这些记忆。
嵌入是由 AI模型(例如大型语言模型)生成的,并具有许多属性或特征,这使得它们的表示形式难以管理。在AI和机器学习的背景下,这些特征代表了数据的不同维度,这对于理解模式、关系和底层结构至关重要。
处理向量数据所面临的挑战是,传统的基于标量(scalar-based)的数据库无法跟上此类数据的复杂性和规模,这使得提取见解和执行实时分析变得困难。这就是向量数据库发挥作用的地方——它们是专门为处理这种类型的数据而设计的,并提供了您从数据中获取最大价值所需的性能、可扩展性和灵活性。
我们看到下一代向量数据库正在引入更复杂的架构,以解决智能应用的高效成本和扩展问题。这种能力由serverless向量数据库处理,它可以将存储成本和计算成本分离,从而为 AI提供低成本的知识支持。
通过使用向量数据库,我们可以为我们的 AI添加知识,例如语义信息检索、长期记忆等。下图让我们更好地理解向量数据库在此类应用中的作用:
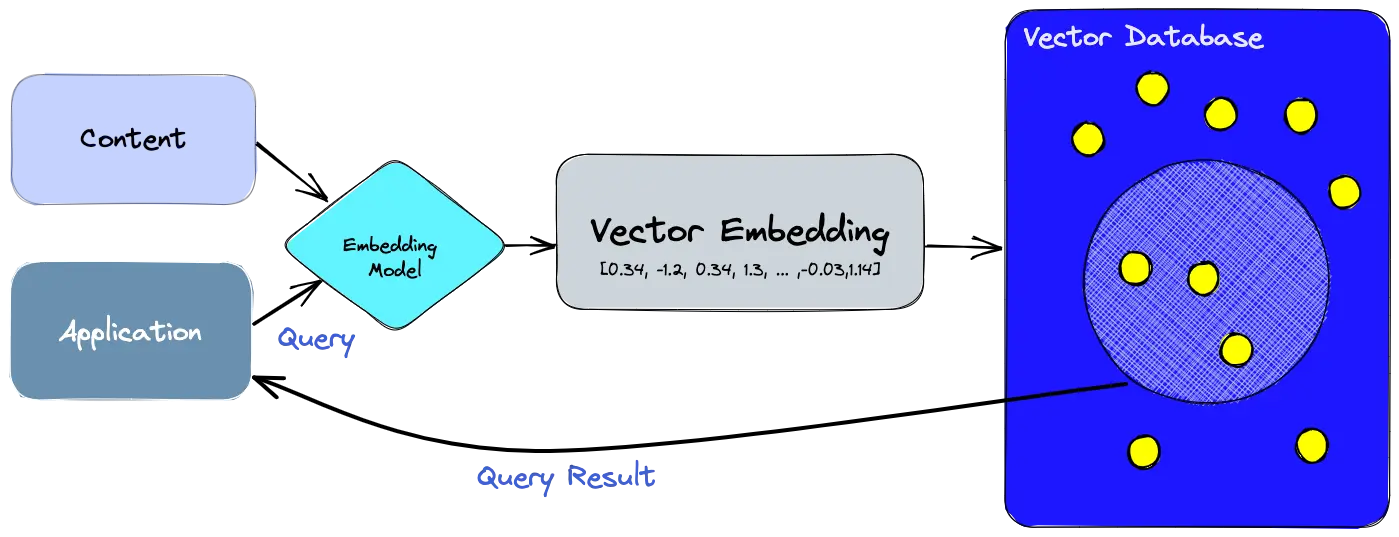
我们来分解一下这个流程:
- 首先,我们使用嵌入模型EmbeddingModel为我们想要索引的内容content创建向量嵌入。
- 该向量嵌入被插入到向量数据库VectorDatabase中,并附带一些对创建该嵌入的原始内容的引用。
- 当应用程序发出查询Query时,我们使用相同的嵌入模型EmbeddingModel为该查询创建嵌入。
- 并使用这些查询嵌入来查询数据库,以寻找相似的向量嵌入VectorEmbedding。
- 如前所述,那些相似的嵌入与用于创建它们的原始内容相关联。
向量数据库是如何工作的?
我们(或多或少)都知道传统数据库是如何工作的——它们将字符串、数字和其他类型的标量数据存储在行和列中。另一方面,向量数据库操作的是向量,因此它的优化和查询方式大不相同。
在传统数据库中,我们通常查询的是数据库中值与我们的查询完全匹配的行。在向量数据库中,我们应用一种相似性度量来查找与我们的查询最相似的向量。
向量数据库使用了参与近似最近邻 (ANN)搜索的不同算法的组合。这些算法通过哈希 (hashing)、量化(quantization) 或基于图 (graph-based) 的搜索来优化搜索。
这些算法被组装成一个流水线(pipeline),可以快速准确地检索到被查询向量的“邻居”。由于向量数据库提供的是近似结果,我们主要权衡的是准确性和速度。结果越准确,查询就会越慢。然而,一个好的系统可以在近乎完美的准确性下提供超快的搜索。
以下是向量数据库的常见流水线:
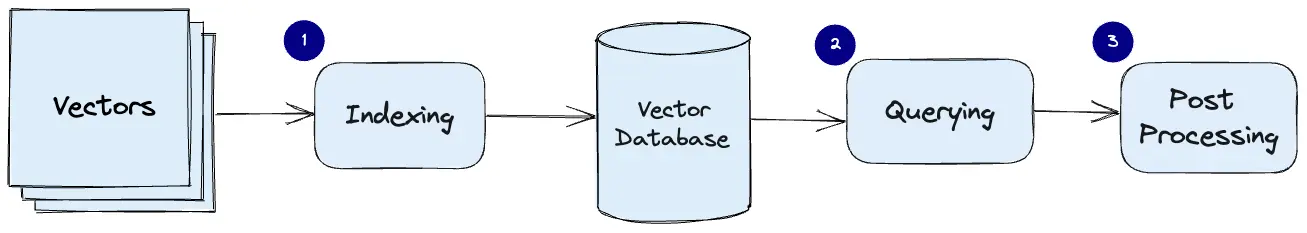
- 索引 (Indexing): 向量数据库使用诸如 PQ、LSH 或HNSW之类的算法(下文将详细介绍)来索引向量。此步骤将向量映射到一个能够实现更快搜索的数据结构中。
- **查询 (Querying):**向量数据库将索引化的查询向量与数据集中已索引的向量进行比较,以找到最近的邻居(应用该索引所使用的相似性度量)。
- **后处理 (Post Processing):**在某些情况下,向量数据库会从数据集中检索最终的最近邻,并对它们进行后处理以返回最终结果。此步骤可以包括使用不同的相似性度量对最近邻进行重新排序。
Serverless向量数据库 (Serverless Vector Databases)
Serverless代表了向量数据库的下一次进化。上述的(第一代)架构让我们拥有了准确、快速、可扩展但昂贵的向量数据库架构。随着AI 用例的兴起,成本和弹性变得越来越重要,第二代 serverless向量数据库应运而生。
serverless 的意思是:你(开发者)不再需要关心和管理服务器。
你不再需要为“空闲”的计算资源付费,系统会根据你的查询需求“弹性”地、自动地(你无感知)增减计算资源。这使得成本大大降低。
第一代向量数据库有三个关键痛点,而 serverless向量数据库解决了这些问题:
- 存储与计算的分离:为了优化成本,计算应该只在需要时使用。这意味着将索引存储与查询解耦,并且只搜索需要的部分——当涉及到延迟时,这变得越来越困难。
- 多租户: 处理索引中的命名空间(namespaces),以确保不经常查询的命名空间不会增加成本。
- 新鲜度 (Freshness):向量数据库需要提供新鲜的数据,这意味着在新数据插入后的几秒钟内,它就是可查询的。(注意:对于Pinecone Serverless,在插入大量数据时,新鲜度可能会有延迟。)
存储和计算分离
为了将存储和计算分离,高度复杂的几何分区算法(geometric partitioning algorithms)可以将一个索引分解为多个子索引,使我们能够将搜索集中在特定的分区上:
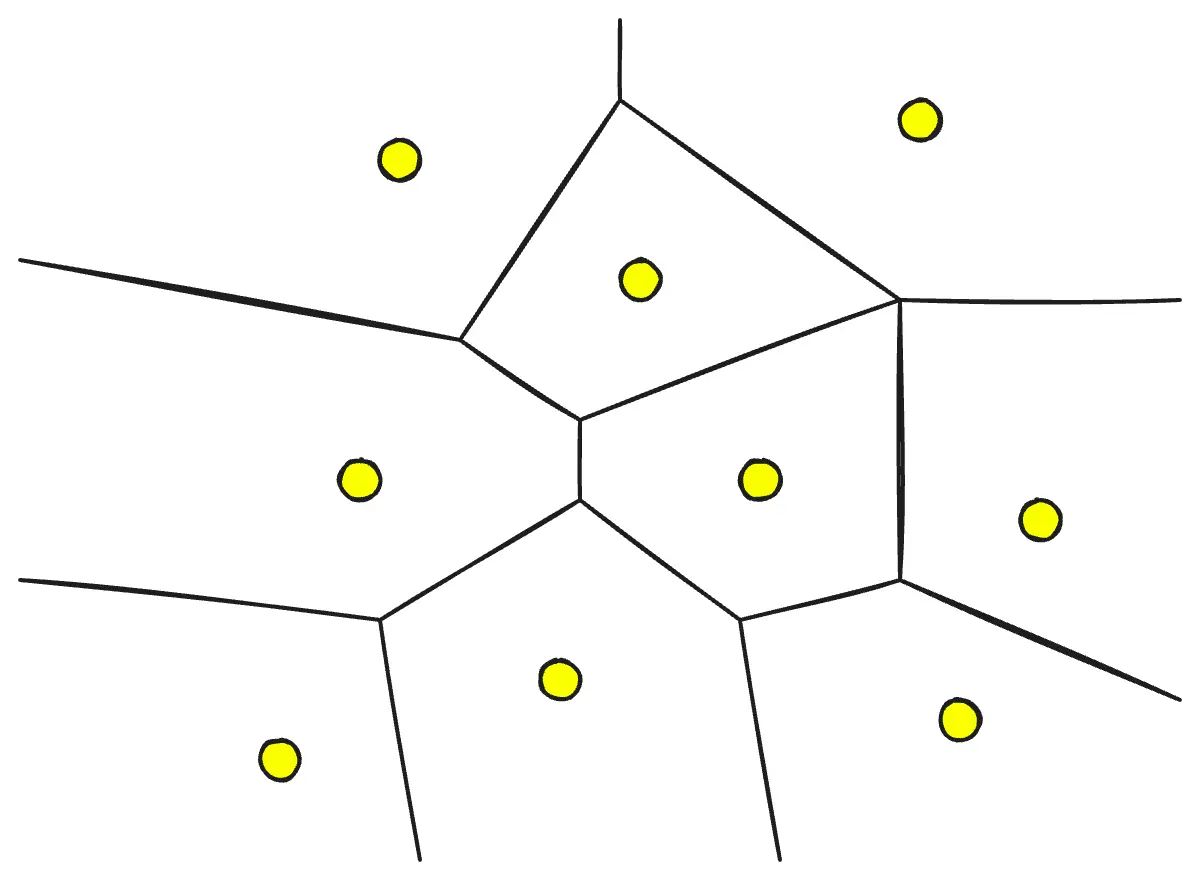
[图片:Voronoi 泰森多边形分区图]
通过这些分区,查询的搜索空间可以只关注向量索引的几个部分,而不是完整的搜索空间。典型的搜索行为会显示,某些分区比其他分区被访问得更频繁,这使我们能够在计算成本和冷启动时间之间进行调整,以找到成本和延迟之间的最佳平衡。
当我们进行这种分区时,我们就解决了计算和存储分离的问题。然而,几何分区在索引构建时是一个较慢的过程。这意味着我们可能会遇到“新鲜度”问题,因为我们必须等待新数据被正确地存储在索引中。
新鲜度问题
想象一个拥有数亿册藏书的巨型图书馆。为了让你 0.1秒就能找到任何一本书,馆长(数据库)使用了一套极其复杂的“几何分区”算法来给书排序上架。这个“上架”过程(即“索引构建”)非常缓慢且复杂。
“新鲜度”问题 (The Problem):在你(用户)看来,你刚捐了一本新书(插入一个新向量),你立刻去查询它,图书馆电脑却说“查无此书”。因为这本书还在馆长的“待上架”推车里,还没进入那个“主索引”系统。
- 新鲜度 (Freshness)指的就是:“数据在写入后,多久能被查询到?”
- 如果等待主索引构建完成,这个延迟(write-to-readlatency)会非常长,知识就不“保鲜”了。
“新鲜度层”的解决方案 (The Solution):为了解决这个问题,图书馆在入口处放了一个“新书速递架”(Freshness Layer)。
- 写入:当一本新书(新向量)送达时,图书馆同时做两件事:
- (a)把书交给馆长,让他去执行那个“缓慢的”上架流程(构建主索引)。
- (b)同时,把这本书的“副本”或“索引卡”放在入口的“新书速递架”上。
- 查询:当你(用户)来查书时,系统会同时查询两个地方(这就是文章里“查询路由器”的作用)。它牺牲了一点点的查询效率(因为要查两个地方),换取了极高的数据“新鲜度”(即“知识保鲜”)。
- (a) 查询“主索引”(那个巨型图书馆)。
- (b) 也查询“新书速递架”(这个小架子)。
为了解决这个问题,向量数据库需要另一个单独的层,称为**“新鲜度层”(freshnesslayer)。这个新鲜度层充当一个临时的向量“缓存”**,可以被查询。与此同时,我们等待索引构建器将新向量放入几何分区的索引中。
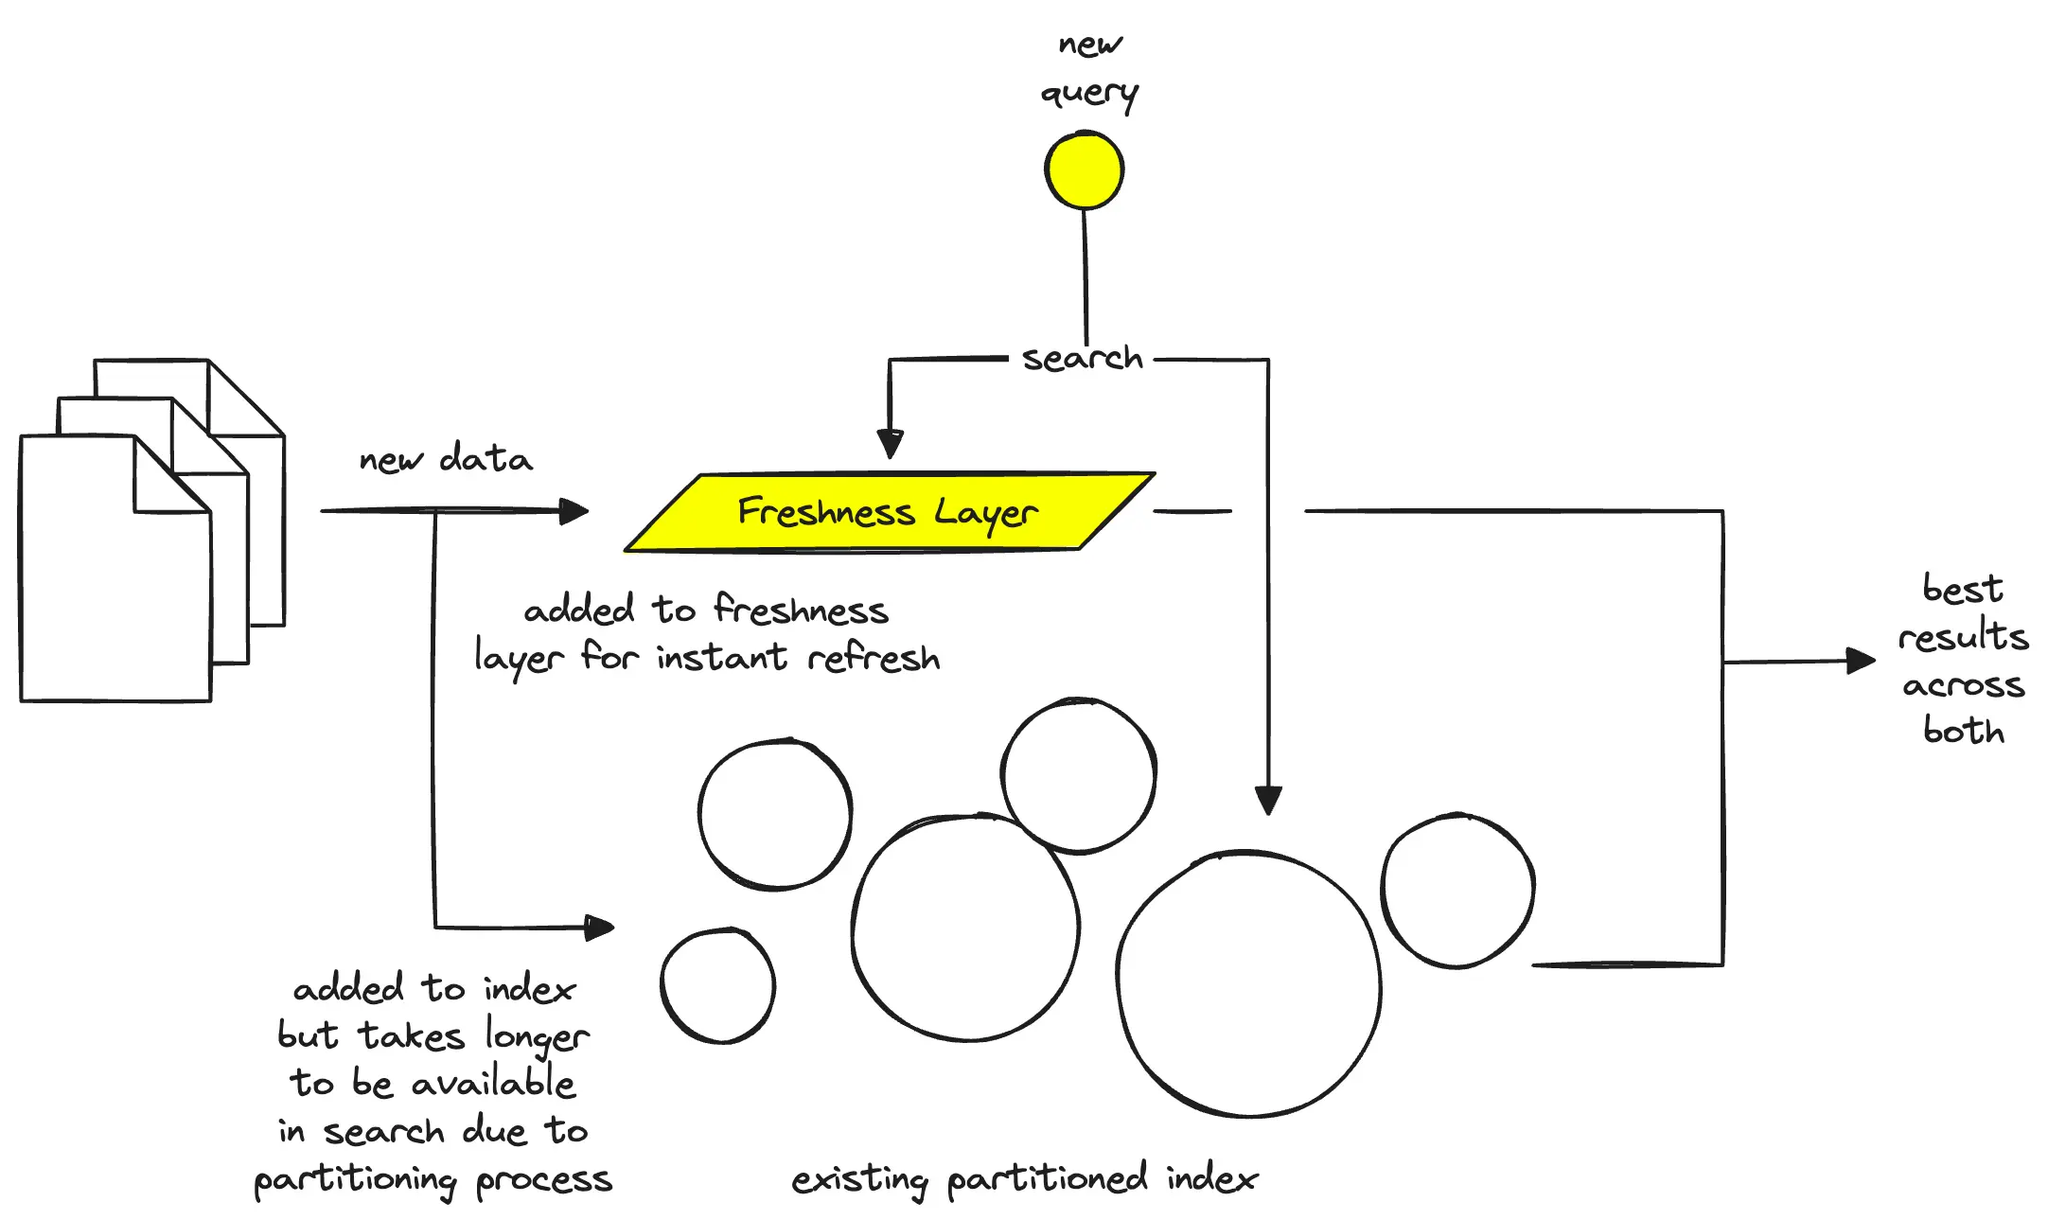
新鲜度层使我们的数据保持最新,因此我们可以快速开始查询。
在此过程中,一个**查询路由器 (query router)**可以将查询同时发送到主索引和新鲜度层——从而解决了新鲜度问题。然而,值得注意的是,新鲜度层存在于计算实例中,因此我们不能在那里存储完整的索引。相反,我们等待新向量被插入到主索引中——一旦完成,它们就会从新鲜度层中移除。
多租户问题
最后,是多租户问题。许多第一代向量数据库可以处理多租户,并且已经这样做了很长时间。然而,serverless架构中的多租户更为复杂。
我们必须避免将不同类型的用户共置 (co-locate)在相同的硬件上,以保持低成本和低延迟。如果我们将用户A(每天几乎每秒进行 20 次查询)与用户 B(每月进行 20次查询)放在同一硬件上,用户 B 将被迫 24/7全天候占用计算硬件,因为这是用户 A 所需的持续低延迟所必需的。
为了解决这个问题,向量数据库必须能够识别具有相似使用情况的用户,并将他们共置在一起,同时保持他们之间的完全分离。同样,这可以基于用户的使用指标以及基于使用情况自动分配“热/冷”基础设施来完成。
小结
将第一代向量数据库加上存储与计算的分离、多租户和新鲜度,我们就得到了新一代的现代向量数据库。这种架构(与向量数据库的基础知识相结合)是现代AI 技术栈的首选。